仿真环境
提供场景观测与交互接口,让智能体在可重复环境中学习。
本平台面向多平台、多任务的智能决策需求,旨在构建贯通场景配置、策略训练、模型管理与仿真应用的全生命周期技术体系。按照“平台—任务”层级组织训练,通过参数化场景建模与任务规则配置,以 PPO 近端策略优化为算法基础,结合多智能体协同与博弈对抗训练,提升智能体在复杂动态环境中的决策能力。实现从实体到数字样机,从数字样机到规则体,从规则体到智能体反向驱动实体的动态演进。
产品咨询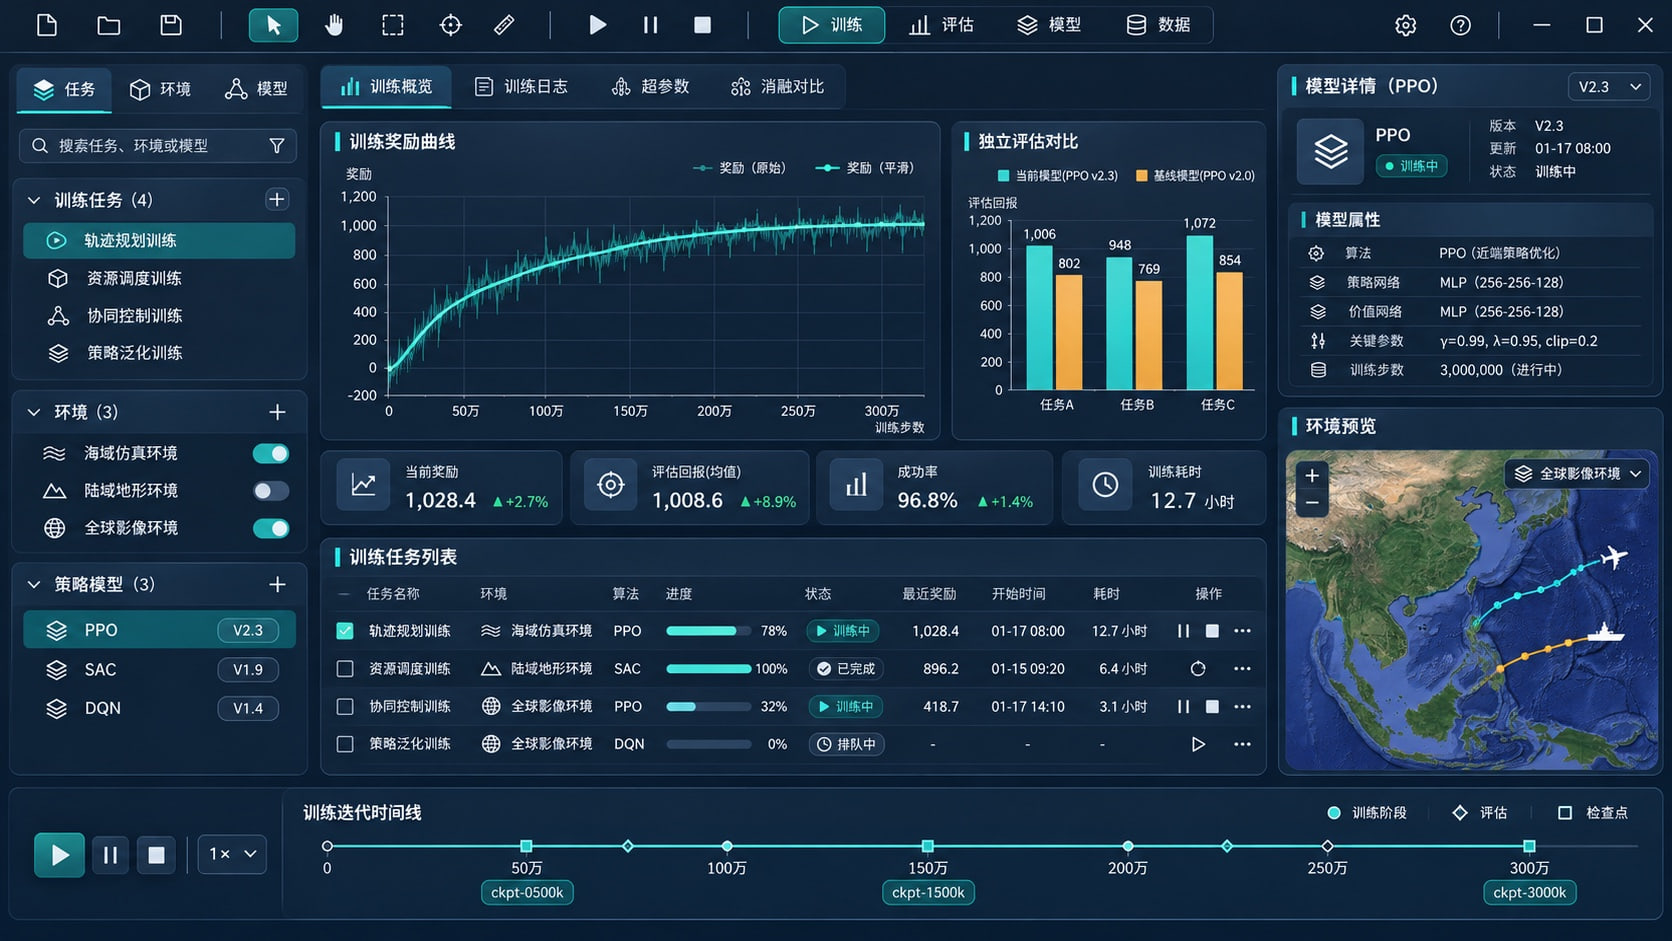
智能体训练平台为智能体提供仿真环境、行为规则、约束条件与任务目标,通过交互学习、奖励反馈和独立评估训练策略模型,输出可复用的智能体模型、训练记录与评估结果,并支持将智能体接入仿真引擎进行推理验证。
提供场景观测与交互接口,让智能体在可重复环境中学习。
组织行为规则、动作范围与约束条件,明确任务边界。
通过任务目标与奖励反馈描述训练方向,记录完成情况。
管理策略模型与评估结果,支持仿真验证和版本比较。
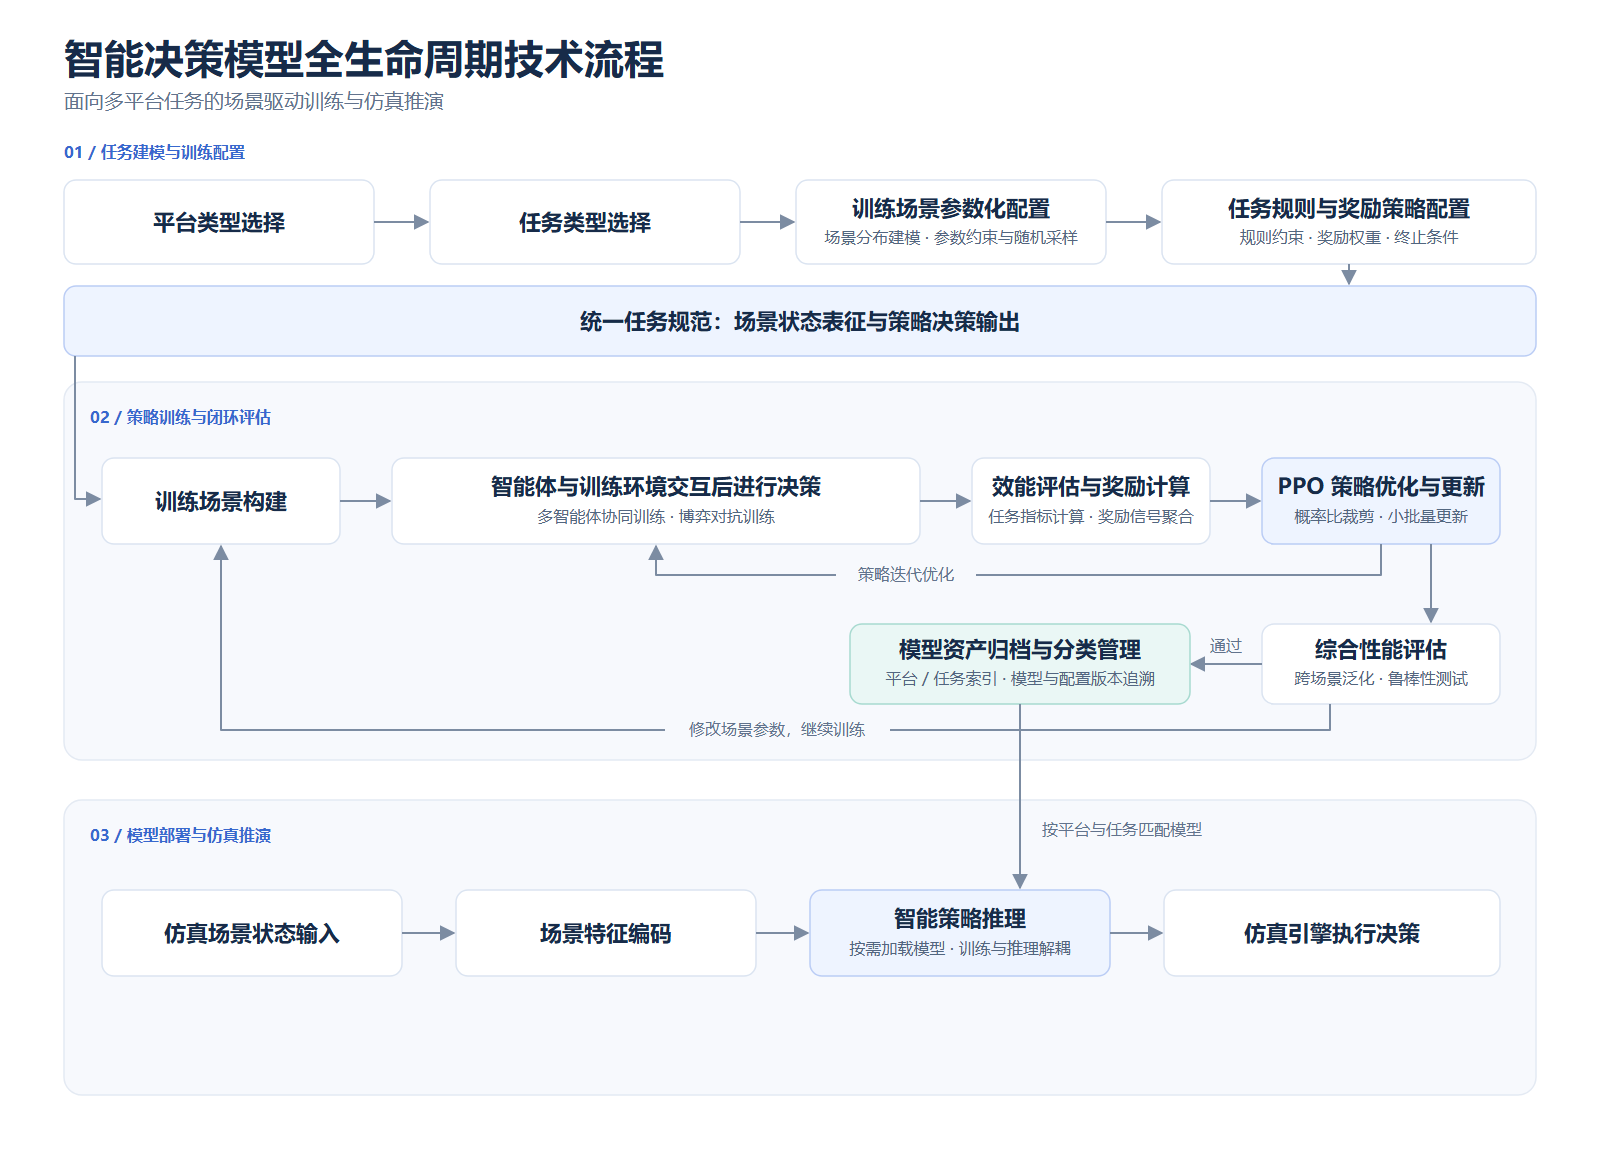
智能体训练平台为智能体提供仿真环境、行为规则、约束条件与任务目标,通过交互训练和反馈评估形成可复用的策略模型。平台能够与深蓝 2.0 联动,以仿真实体为起点,贯通“实体—数字体—规则体—智能体”的转变。训练完成后,策略模型可接入深蓝 2.0 参与仿真推演,以推演中的决策与反馈反向驱动引擎演进。
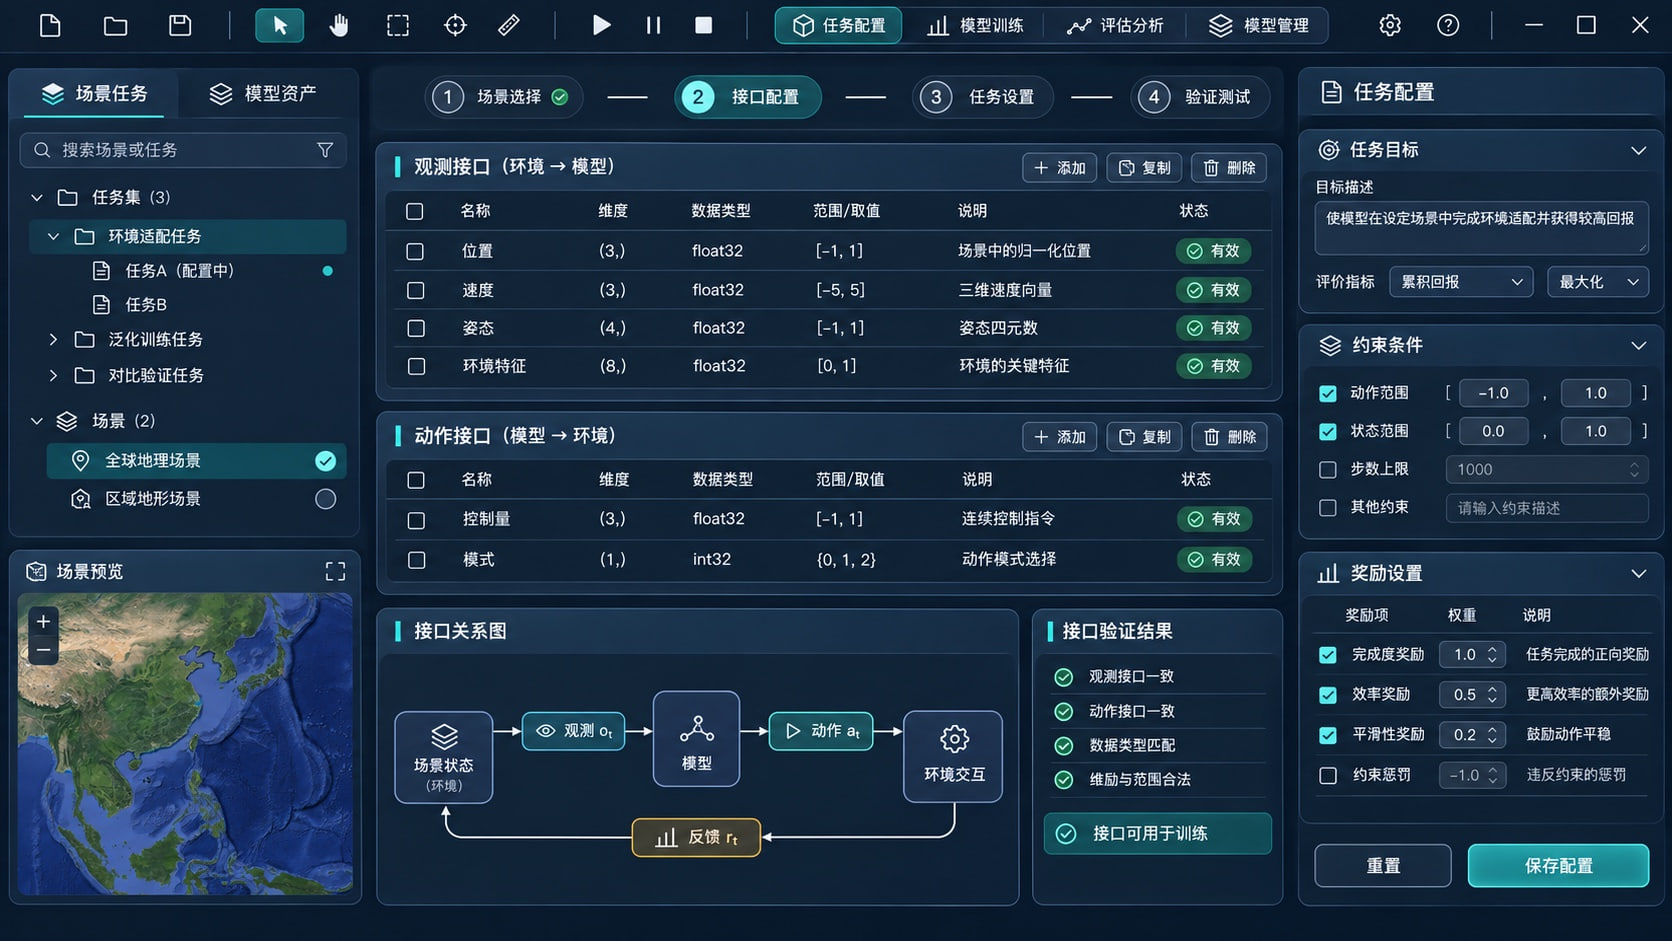
为智能体提供可交互的仿真环境,配置任务目标、行为规则与约束条件,将场景状态转换为模型观测,明确动作接口及奖励反馈,形成可重复的训练任务。
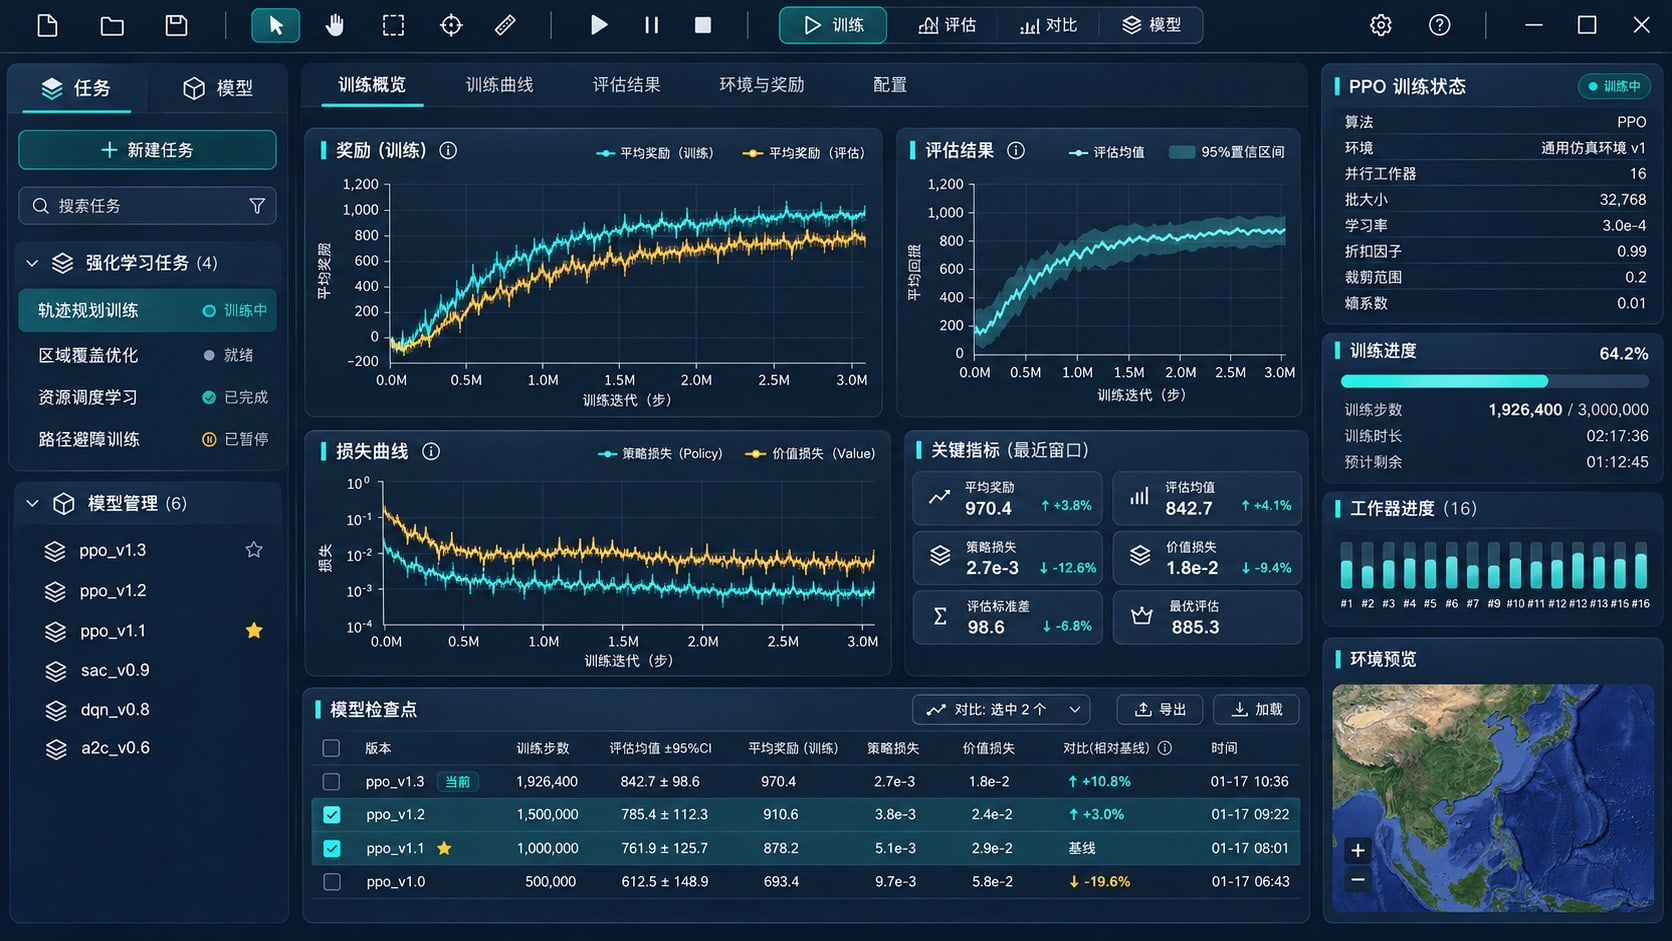
通过强化学习等交互训练方式,智能体依据场景观测输出动作,由环境返回结果与奖励反馈。结合独立评估比较任务完成情况、约束满足情况与模型表现,迭代形成可保存、可对比的策略模型。
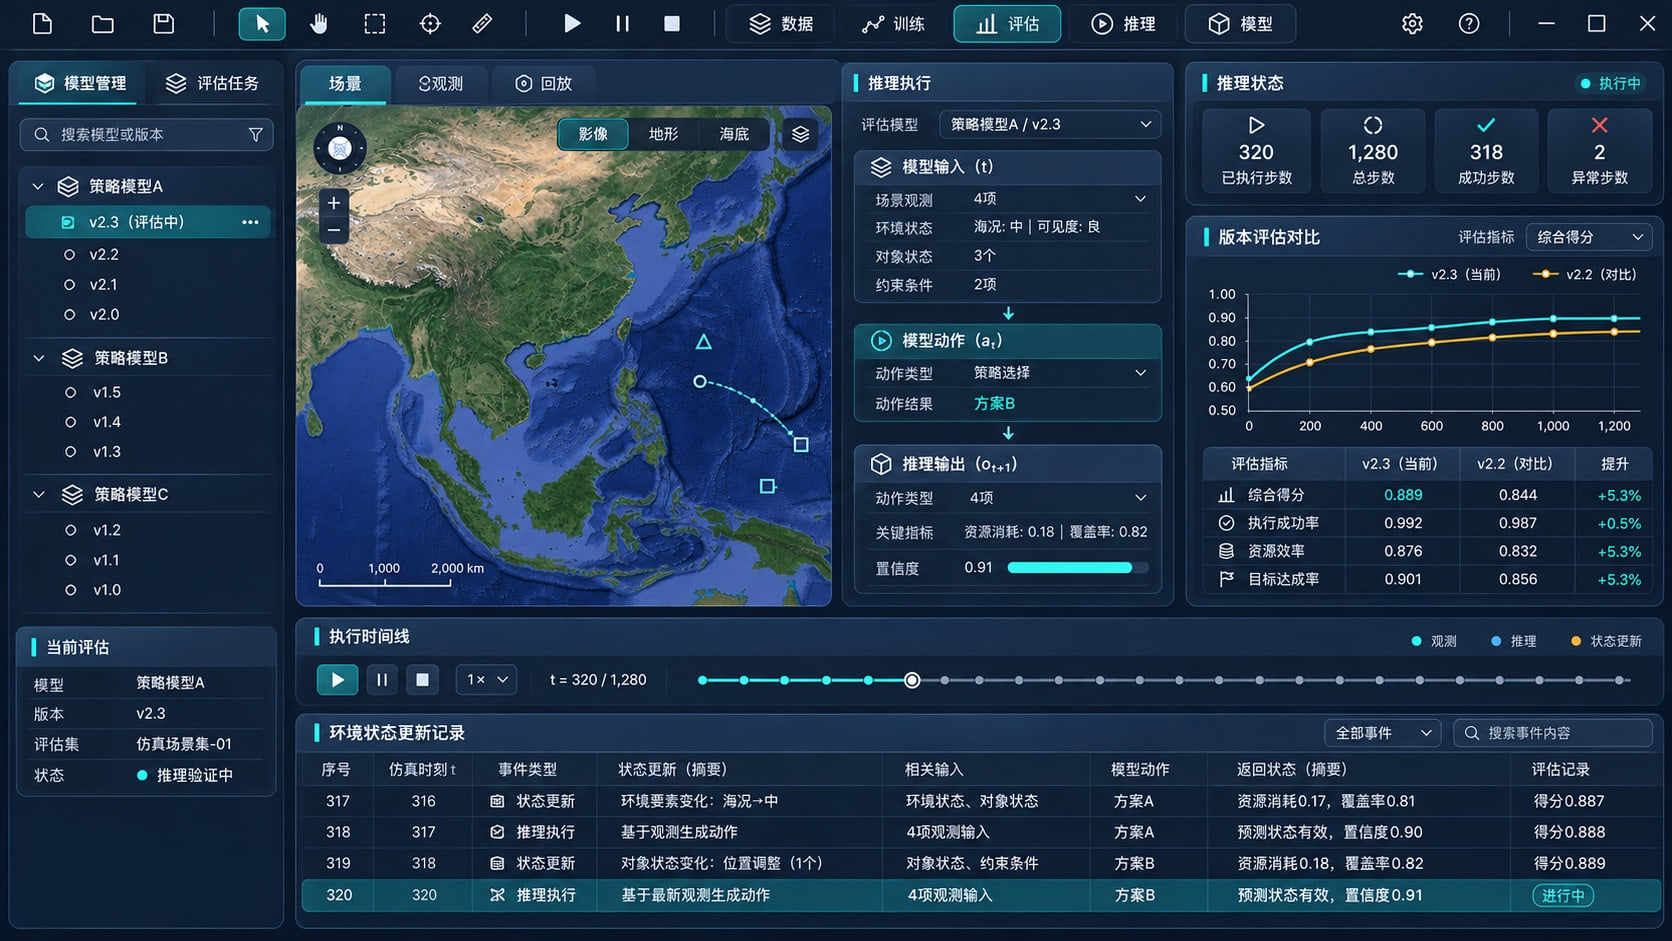
将经过评估的策略模型接入仿真引擎,根据实时场景观测生成决策,由引擎执行并返回更新后的环境状态。通过不同场景下的仿真验证输出过程记录与评估结果,支持模型复用、版本比较和持续迭代。
携手探索数字海洋
产品咨询、技术交流与合作洽谈
 关注产品与公司动态